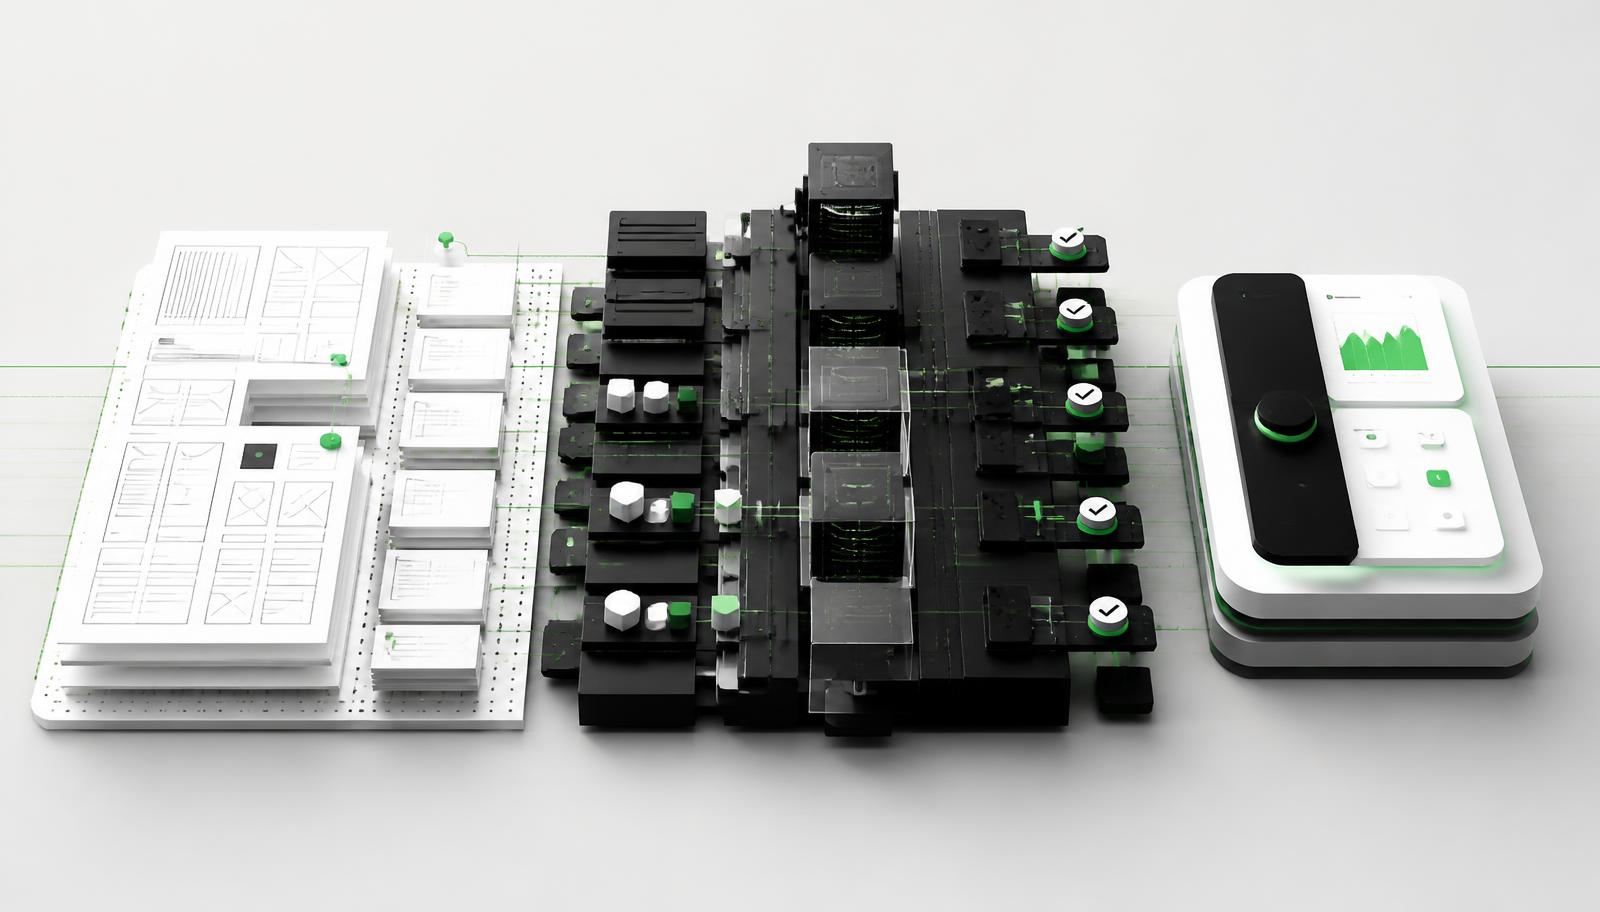
Ein Vorstandstermin steht fest. Ein Wettbewerber war zuerst am Markt. Ein Legacy-System blockiert den Umsatz. In jedem dieser Fälle verlangen Führungskräfte Geschwindigkeit. Doch ein schneller Softwareentwicklungsprozess bedeutet nicht einfach, dass ein Team schneller Code schreibt. Er ist ein Produktionssystem, das ein definiertes Produktziel in verifizierte Software übersetzt, ohne dass Unklarheit, Abkürzungen oder Nacharbeit den scheinbaren Zeitgewinn aufzehren.
Diese Unterscheidung ist wichtig, weil klassische Delivery aus Gründen langsam ist, die wenig mit Tippgeschwindigkeit zu tun haben. Der Scope verteilt sich auf Dokumente und Meetings. Architekturentscheidungen werden uneinheitlich getroffen. Anforderungen ändern sich, ohne dass die Auswirkungen auf Schätzungen sichtbar werden. Tests finden erst gegen Ende statt, wenn Fehler teurer zu beheben sind. KI kann einzelne Aufgaben beschleunigen, aber kein ungesteuertes Betriebsmodell reparieren.
Warum Geschwindigkeit in klassischer Delivery meist scheitert
Die meisten Softwareprojekte verpassen Termine nicht wegen mangelnder Fähigkeiten der Engineers. Sie verpassen sie, weil die Arbeit das Engineering in einer Form erreicht, die sich nicht sauber umsetzen lässt. Produktanforderungen beschreiben vielleicht die Absicht der Nutzer, lassen aber Ausnahmefälle, Berechtigungen, Integrationen, Reporting-Regeln und operative Grenzen aus. Das Team entdeckt diese Details während der Entwicklung und überarbeitet wiederholt Design, Schätzungen und Code.
An diesem Punkt werden klassische Nearshore- und Agenturmodelle teuer. Ein grösseres Team scheint zunächst Dynamik zu erzeugen, doch mit jeder neuen Rolle, Übergabe und Klärungsschleife wächst der Koordinationsaufwand. Statusberichte können Fortschritt zeigen, während das eigentliche Produkt schwer zu testen, auszurollen oder zu ändern bleibt.
Generative KI beseitigt dieses Problem nicht von selbst. Ein KI-Coding-Assistent kann einzelne Aufgaben beschleunigen, erzeugt aber häufig Unterschiede bei Implementierungsentscheidungen, Codestil, Abhängigkeiten und Testabdeckung. Die Qualität von Prompts wird zum versteckten Delivery-Risiko. Das Ergebnis kann schnellere Codeproduktion sein, ohne dass das Produkt schneller geliefert wird.
Befehle statt Prompts. Das Engineering-Team bleibt für Entscheidungen verantwortlich, während die Plattform die wiederholbaren Teile des Prozesses trägt.
Der schnelle Softwareentwicklungsprozess beginnt vor dem Coding
Die schnellsten zuverlässigen Projekte investieren früh darin, kommerzielle Absichten in ein ausführbares System zu übersetzen. Das ist keine Rückkehr zu langen Spezifikationsphasen. Es ist ein kurzer, strukturierter Discovery-Prozess, der jene Unsicherheit beseitigt, die später unnötige Schleifen verursacht.
Das Produkt als Delivery-System definieren
Eine glaubwürdige Discovery-Phase schafft mehr als eine Feature-Liste. Sie definiert die relevanten User Journeys, Geschäftsregeln, Rollen und Berechtigungen, Integrationsgrenzen, Datenflüsse, nichtfunktionale Anforderungen, Release-Prioritäten und Akzeptanzkriterien. Sie legt auch fest, was bewusst ausserhalb des Scopes liegt.
Dieses Ergebnis sollte maschinenlesbar genug sein, um Entwicklung, Tests und Schätzungen zu steuern. Wenn eine Anforderung auf drei Arten interpretiert werden kann, ist sie weder für ein Delivery-Team noch für einen KI-gestützten Workflow bereit. Das Ziel ist keine perfekte Vorhersage, sondern Unsicherheit so weit zu reduzieren, dass das Team sich auf einen Plan festlegen und verbleibende Annahmen erklären kann.
Auch Architektur gehört in diese Phase. Entscheidungen zu Mandantenfähigkeit, Authentifizierung, Datenhoheit, Audit Trails, Performance-Grenzen, Drittanbieterdiensten und Deployment-Umgebungen sind keine technischen Details, die man aufschieben sollte. Sie bestimmen Kosten, Delivery-Reihenfolge, Sicherheitsrisiken und künftige Wartung.
Scope in unabhängig verifizierbare Arbeit zerlegen
Sobald das Produktmodell klar ist, wird der Scope zu einer geordneten Folge von Delivery-Einheiten statt zu einem Backlog lose verbundener Tickets. Jede Einheit braucht definiertes Verhalten, technische Grenzen, erwartete Testabdeckung und Akzeptanznachweise.
Das verändert die Wirtschaftlichkeit der Delivery. Engineers verbringen weniger Zeit damit, vage Anfragen zu übersetzen. Produktverantwortliche sehen, was gebaut und verifiziert wurde und welche Auswirkungen eine Änderung hat. Schätzungen werden glaubwürdiger, weil sie auf definierter Arbeit statt auf einem allgemeinen Versprechen beruhen. Gleichzeitig entsteht eine klare kommerzielle Grenze zwischen zugesagtem Scope, genehmigten Änderungen und offenen Fragen.
Mit gesteuerten, Repository-basierten Workflows entwickeln
An der Delivery Engine werden viele KI-Versprechen schwer belegbar. Die entscheidende Frage ist nicht, ob ein Modell Code erzeugen kann. Entscheidend ist, ob das Team Änderungen über alle Engineers hinweg und dauerhaft konsistent erzeugen, prüfen, testen und veröffentlichen kann.
Ein gesteuerter Workflow beginnt im Repository, wo der tatsächliche Produktkontext liegt. Er berücksichtigt etablierte Muster, Architekturregeln, Coding-Standards, Abhängigkeiten, bestehende Tests und Deployment-Anforderungen. Engineers starten feste Workflows für definierte Aufgaben, prüfen das Ergebnis, treffen dort fachliche Entscheidungen, wo das Produkt sie erfordert, und verifizieren jede Änderung vor dem nächsten Schritt.
Testen, solange Änderungen noch günstig sind
Qualität kann in einem schnellen Modell keine abschliessende Projektphase sein. Dann sind Abhängigkeiten bereits verflochten, der Release-Druck ist hoch und Teams neigen dazu, Fehler als Arbeit nach dem Launch einzuordnen. Tests müssen die Delivery auf mehreren Ebenen begleiten: Unit-Verhalten, Integrationspfade, End-to-End User Journeys, Sicherheitsprüfungen, Performance-Risiken und Regressionen.
Nicht jedes Projekt braucht denselben Testmix. Ein reguliertes internes System erfordert möglicherweise stärkere Audit- und Zugriffsnachweise. Bei einem Consumer-SaaS-Launch stehen eher Checkout, Onboarding, mobiles Verhalten und Last im Fokus. Das Prinzip bleibt gleich: Tests müssen mit dem definierten Scope verbunden sein und dürfen nicht informellen manuellen Prüfungen überlassen werden.
Engineer-geführte Qualitätssicherung bleibt notwendig. Automatisierte Kontrollen können Muster erkennen, erwartetes Verhalten validieren und Regressionen skalierbar finden. Sie können aber unklare Interaktionen, unvollständige Geschäftslogik oder die Praxistauglichkeit eines Workflows nicht vollständig beurteilen. Das richtige Modell verbindet Automatisierung mit verantwortlicher menschlicher Prüfung, statt das eine als Ersatz für das andere darzustellen.
Qualität als Delivery-Input messen, nicht als Aufräumarbeit
Technische Schulden werden oft als Preis für Geschwindigkeit betrachtet. Dieser Zielkonflikt ist überholt. Manche Schulden sind bewusst und wirtschaftlich sinnvoll, etwa bei der Marktvalidierung oder wenn eine risikoarme Funktion verschoben wird. Unbemessene Schulden sind etwas anderes: Sie verringern unbemerkt die Änderungsgeschwindigkeit, erhöhen Vorfälle und machen künftige Schätzungen unzuverlässig.
Kontinuierliche technische Qualitätsanalyse macht diese Risiken während der Entwicklung sichtbar. Die Prüfung muss über Codeformatierung hinausgehen und Abhängigkeitsrisiken, Duplikate, Architekturabweichungen, fehlende Tests, Sicherheitslücken, Performance-Probleme und Wartbarkeits-Hotspots erfassen. Jeder Befund braucht Kontext. Eine lange Liste statischer Warnungen ist keine Qualitätsstrategie – Priorisierung und klare Verantwortung sind es.
- Kann das Team eine Funktion ergänzen, ohne angrenzende Abläufe zu destabilisieren?
- Kann es eine Änderung zu einer Anforderung und einem Testergebnis zurückverfolgen?
- Kann ein anderes Team die Verantwortung übernehmen, ohne das System aus informellem Wissen rekonstruieren zu müssen?
Was Führungskräfte von einem Rapid-Delivery-Partner verlangen sollten
Ein glaubwürdiges Rapid-Delivery-Projekt sollte seine Kontrollen sichtbar machen. Fragen Sie, wie der Scope formalisiert wird, wie sich Schätzungen bei geänderten Anforderungen verändern, wie der Repository-Kontext die KI-gestützte Arbeit beeinflusst und welche Qualitätsprüfungen vor dem Release verpflichtend sind. Fragen Sie, wer Architekturentscheidungen verantwortet, generierten Code prüft und welche Nachweise die Funktion eines Features bestätigen.
Seien Sie vorsichtig bei pauschalen Versprechen. Ein klar abgegrenztes SaaS-Produkt, eine interne Workflow-Plattform oder ein Modernisierungsprogramm lässt sich oft in einem Bruchteil der klassischen Zeit liefern. Ein Projekt mit ungeklärter Strategie, komplexen Legacy-Abhängigkeiten, mehreren externen Freigaben oder unklarer Datenhoheit wird durch KI nicht deterministisch. Der richtige Partner legt diese Grenzen früh offen, statt sie hinter einem Geschwindigkeitsversprechen zu verstecken.
Auch die kommerzielle Struktur zählt. Ein festes Ergebnis braucht definierten Scope und explizite Annahmen. Wird jede Anfrage informell angenommen, sind weder Preis noch Zeitplan wirklich planbar. Starke Delivery-Teams ermöglichen Änderungen, machen deren Auswirkungen aber vor Arbeitsbeginn sichtbar.
Das System aufbauen, bevor die Deadline da ist
Die Unternehmen, die Software schneller liefern, sind nicht jene, die Engineers härter arbeiten lassen oder die meisten KI-Tools sammeln. Sie beseitigen Unklarheit vor der Umsetzung, verankern Expertenpraktiken in wiederholbaren Workflows, verifizieren jedes Inkrement kontinuierlich und halten technische Risiken sichtbar.
Diesen Standard sollten Sie auf Ihren nächsten Produktlaunch oder Rebuild anwenden. Bevor Sie einen Zeitplan freigeben, fragen Sie, ob der Delivery-Prozess nachweisen kann, was gebaut, wie es getestet und wer es verantworten wird, wenn der Launch-Druck vorbei ist.
Übersetzen Sie Ihr nächstes Produktziel in einen ausführbaren, gesteuerten Delivery-Plan, der schnell ist, ohne Risiken aus der Zukunft zu leihen.